外觀
Machine Learning › 監督式學習 › 集成方法
集成方法 (Ensemble Methods)
組合多個模型,讓預測更準或更穩。三大類的差別在組合的方式與主要降低的誤差(見 Bias-Variance)。
| 類型 | 做法 | 主要降低 | 基本模型 | 筆記 |
|---|---|---|---|---|
| Bagging | 在 bootstrap 樣本上平行訓練多個模型,平均 / 投票 | 變異 | 深樹(高變異、低偏誤) | Bagging、隨機森林 |
| Boosting | 依序訓練,每個新模型修正前面的錯誤 | 偏誤(也降變異) | 淺樹(弱學習器) | AdaBoost、Gradient Boosting、XGBoost |
| 異質組合 | 不同類型的模型投票或由第二層模型組合 | 視情況 | 任意 | Voting、Stacking |
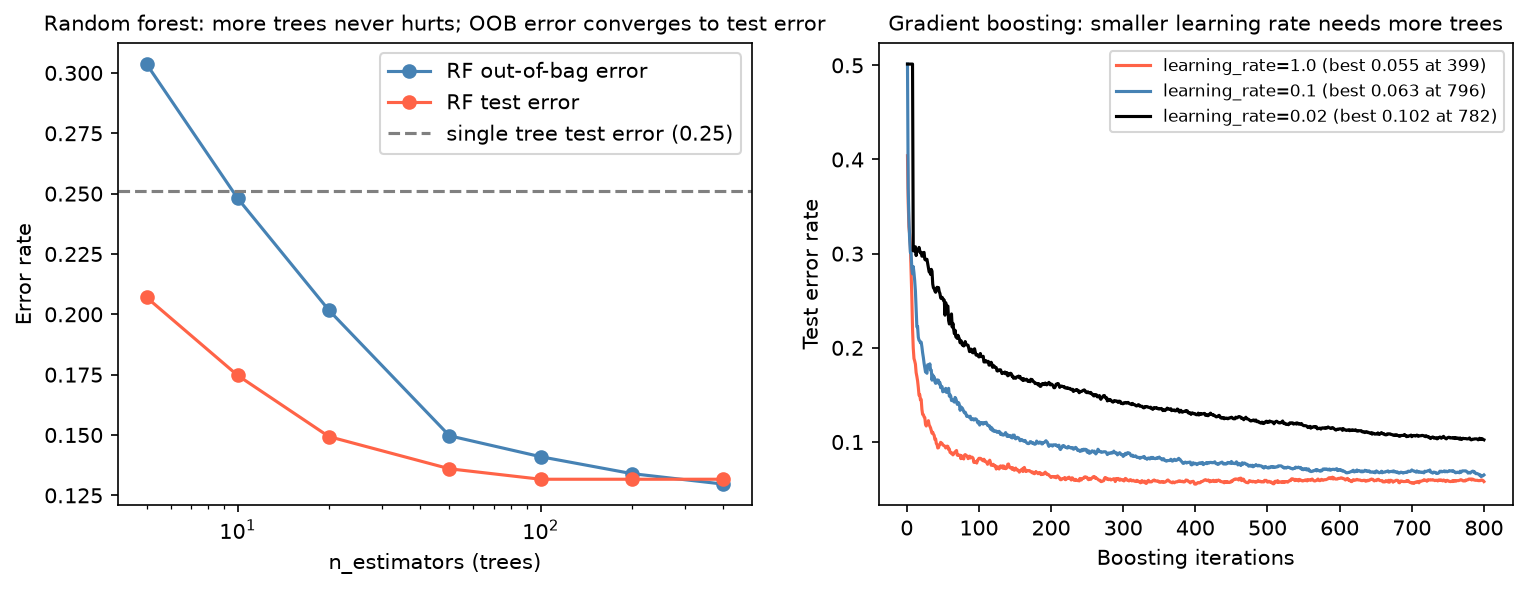
左:隨機森林的樹越多,誤差單調下降後持平(單棵樹 0.25 → 森林 0.13),樹多不會過擬合,只是變慢。右:Boosting 的學習率越小,需要越多輪才收斂;輪數是要調的參數(early stopping)。
乳癌資料的實際比較
5-fold CV AUC(訓練集 398 筆、30 個特徵):
| 模型 | CV AUC |
|---|---|
| SVM (RBF) | 0.993 |
| Stacking(RF + SVM + KNN → 邏輯斯) | 0.993 |
| 邏輯斯迴歸 | 0.992 |
| Soft voting | 0.992 |
| AdaBoost、XGBoost、LightGBM | 0.991–0.992 |
| Extra Trees、隨機森林、Gradient Boosting、HistGB | 0.983–0.991 |
| Bagging(決策樹) | 0.981 |
| 單棵決策樹 | 0.912 |
集成方法對單棵樹是巨大改進(0.91 → 0.98+),但在這份近乎線性可分的小資料上,沒有一個集成方法明顯勝過邏輯斯迴歸。集成的價值在大型、非線性、有交互作用的表格資料上才明顯。
怎麼選
| 情境 | 首選 |
|---|---|
| 表格資料、想少調參、要穩健預設 | 隨機森林 |
| 表格資料、要最高分、願意調參 | HistGradientBoosting / XGBoost / LightGBM |
| 已有幾個表現相近但不同類型的模型 | Soft voting → 再試 Stacking |
| 單一不穩定的非樹模型 | Bagging |
提醒
| 提醒 | 原因 |
|---|---|
| 先和單一強 baseline 比 | 增加的複雜度不一定值得 |
| 流程若有洩漏或不穩,集成只會掩蓋問題 | 先把 工作流程 弄對 |
| 部署與解釋成本變高 | 模型大、推論慢、難解釋 |
| 搭配錯誤分析與診斷 | 見 錯誤分析、模型診斷 |