外觀
Machine Learning › 非監督式學習 › 異常偵測 › 距離與密度方法
距離與密度方法 (Distance- and Density-Based Methods)
把「離鄰居很遠」或「位在稀疏區域」的點視為異常。直覺好懂,但對縮放與距離定義非常敏感。
全域 vs 局部異常
| 型態 | 意義 | 適合的方法 |
|---|---|---|
| 全域異常 (global) | 離整體資料都很遠 | KNN 距離、Isolation Forest |
| 局部異常 (local) | 相對於附近的點很奇怪,但整體來看不極端 | LOF |
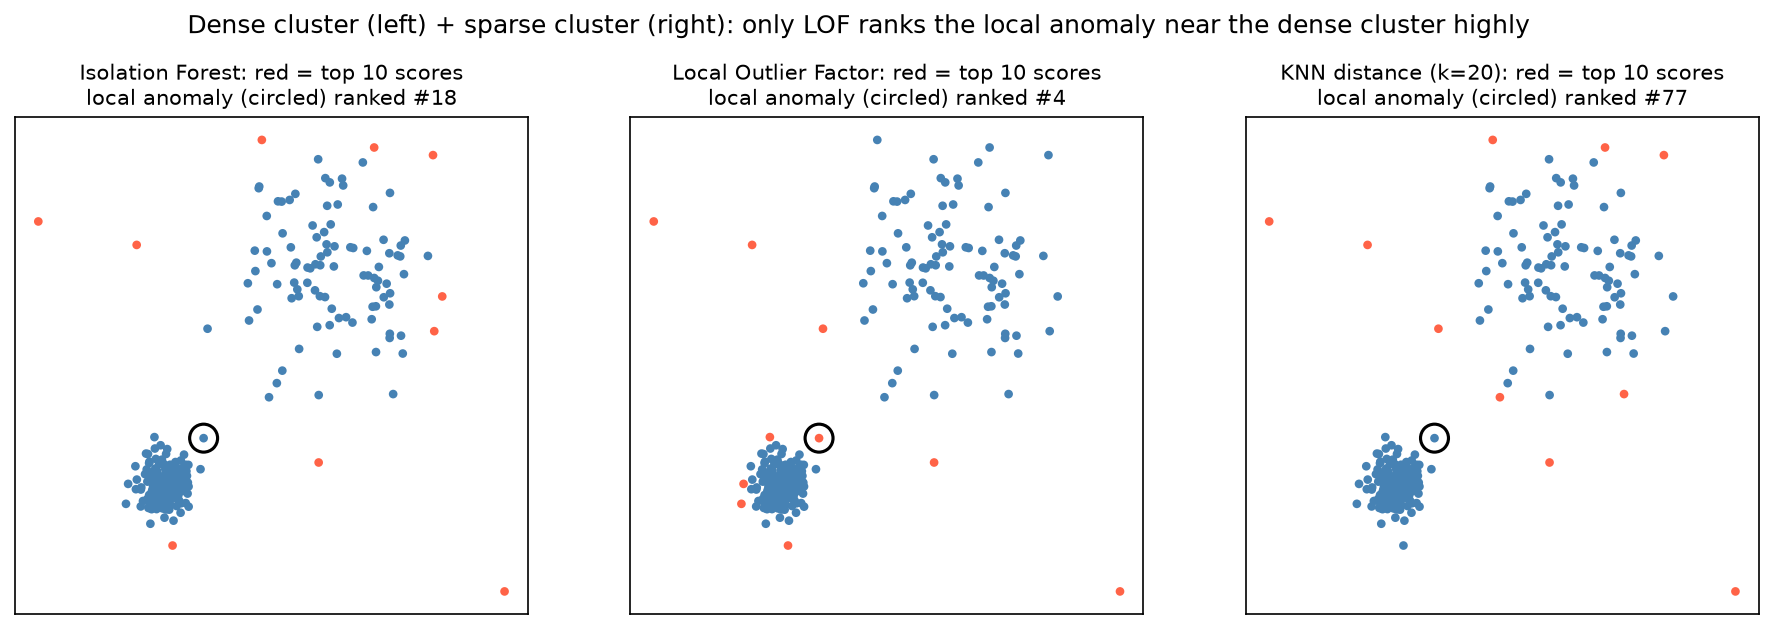
一個緊密的群(左下)與一個稀疏的群(右上),加上一個緊鄰緊密群的局部異常(圈起來)。KNN 距離把它排在第 77 名:它到鄰居的距離,比稀疏群裡的正常點還短。LOF 比較的是「自己的密度 vs 鄰居的密度」,把它排在第 4 名。
KNN 距離
到第 k 個最近鄰(或前 k 個的平均)的距離當作異常分數。
k | 效果 |
|---|---|
| 小 | 非常局部,分數不穩定 |
| 大 | 鄰域較大、分數平滑,局部異常可能被洗掉 |
Local Outlier Factor (LOF)
比較每個點的局部密度與其鄰居的局部密度:
| LOF 值 | 意義 |
|---|---|
| ≈ 1 | 密度和鄰居相近 → 正常 |
| > 1 | 比鄰居稀疏 → 可疑 |
| 遠大於 1 | 局部異常 |
python
import numpy as np
from sklearn.neighbors import LocalOutlierFactor, NearestNeighbors
from sklearn.preprocessing import StandardScaler

X_scaled = StandardScaler().fit_transform(X)          # 一定先縮放

# 1. KNN 距離分數
dist, _ = NearestNeighbors(n_neighbors=21).fit(X_scaled).kneighbors(X_scaled)
knn_score = dist[:, -1]                               # 第 20 個鄰居(第 0 個是自己)

# 2. LOF:離群偵測(對訓練資料本身評分)
lof = LocalOutlierFactor(n_neighbors=20, contamination=0.01)
labels = lof.fit_predict(X_scaled)                    # -1 = 異常
lof_score = -lof.negative_outlier_factor_             # 即 LOF 值,越大越異常

# 3. LOF:新奇偵測(在乾淨資料上 fit,對新資料 predict)
lof_nov = LocalOutlierFactor(n_neighbors=20, novelty=True).fit(X_clean)
lof_nov.predict(X_new)                                # novelty=True 時才能對新資料 predict
pyod 套件有
KNN、LOF等數十種偵測器的統一介面,適合一次比較多種方法。
距離的選擇
| 距離 | 適合 |
|---|---|
| 歐氏 (Euclidean) | 連續、已標準化的特徵(預設) |
| 曼哈頓 (Manhattan) | 稀疏或軸向結構;對單一大差異較不敏感 |
| Cosine | 文字、表現量 profile(看方向不看大小) |
| Gower | 混合型資料(連續 + 序位 + 二元 + 名目) |
| Mahalanobis | 考慮特徵相關;近似多變量常態時 |
混合型資料硬轉成數值再算歐氏距離,異常分數常只是反映編碼方式。Gower 距離在 R 較方便:
r
library(cluster)   # daisy: Gower 距離
library(dbscan)    # lof: 接受 dist 物件

d <- daisy(df, metric = "gower")
lof_score <- lof(d, minPts = 10)     # 舊參數 k 已 deprecated;k 不含點本身,k = 10 等於 minPts = 11
優缺點
| 優點 | 缺點 |
|---|---|
| 直覺、可解釋(「它離鄰居很遠」) | 對縮放敏感 |
| LOF 擅長局部異常與密度不均 | 計算量隨資料量快速成長(需要鄰居搜尋) |
| 距離定義彈性大 | k 的選擇影響結果 |
| 能揭露多變量異常 | 高維時距離失去意義 → 先降維,見 高維小樣本 |
KNN 距離抓不到某個在密集群旁邊看起來明顯可疑的點時,先試 LOF,再下「沒有異常訊號」的結論。