外觀
Machine Learning › 監督式學習 › 集成方法 › 隨機森林
隨機森林 (Random Forest)
Bagging 的決策樹版本,再加上每次分裂只從隨機挑選的部分特徵中選(max_features)。特徵隨機性讓樹之間的相關降低,平均後變異下降更多。幾乎不需要調參就有不錯的表現,是表格資料的穩健預設。
| 隨機性來源 | 作用 |
|---|---|
| Bootstrap 樣本 | 每棵樹看到不同資料 |
| 每次分裂隨機選特徵子集 | 避免所有樹都用同一個最強特徵開頭,降低樹間相關 |
用法
python
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.model_selection import GridSearchCV, StratifiedKFold

# 承乳癌範例
rf = RandomForestClassifier(n_estimators=500, oob_score=True, n_jobs=-1, random_state=0)
rf.fit(X_train, y_train)
rf.oob_score_                    # 0.955(OOB accuracy)
rf.score(X_test, y_test)         # 0.959;測試 AUC 0.996

# 調參:主要調 max_features 與 min_samples_leaf;n_estimators 夠大即可,不需要調
search = GridSearchCV(RandomForestClassifier(n_estimators=300, n_jobs=-1, random_state=0),
                      {"max_features": ["sqrt", 0.3, 0.5], "min_samples_leaf": [1, 3, 5]},
                      cv=StratifiedKFold(5, shuffle=True, random_state=0), scoring="roc_auc")
search.fit(X_train, y_train) # 最佳仍是預設:max_features="sqrt", min_samples_leaf=1| 參數 | 預設 | 說明 |
|---|---|---|
n_estimators | 100 | 越多越穩,不會過擬合;通常 300–1000 |
max_features | 分類 "sqrt";迴歸 1.0 | 越小樹越不相關但單棵越弱;最重要的參數 |
min_samples_leaf | 1 | 增大可平滑預測、降低記憶雜訊 |
max_depth | None | 通常不限,用 min_samples_leaf 控制 |
class_weight | None | "balanced" / "balanced_subsample" 用於不平衡 |
oob_score | False | 需 bootstrap=True |
迴歸的
max_features預設在 sklearn 1.1 起改為1.0(全部特徵,等於 bagging),舊版是"auto"。迴歸時試試"sqrt"或 0.3–0.5,常有幫助。
為什麼樹多不會過擬合
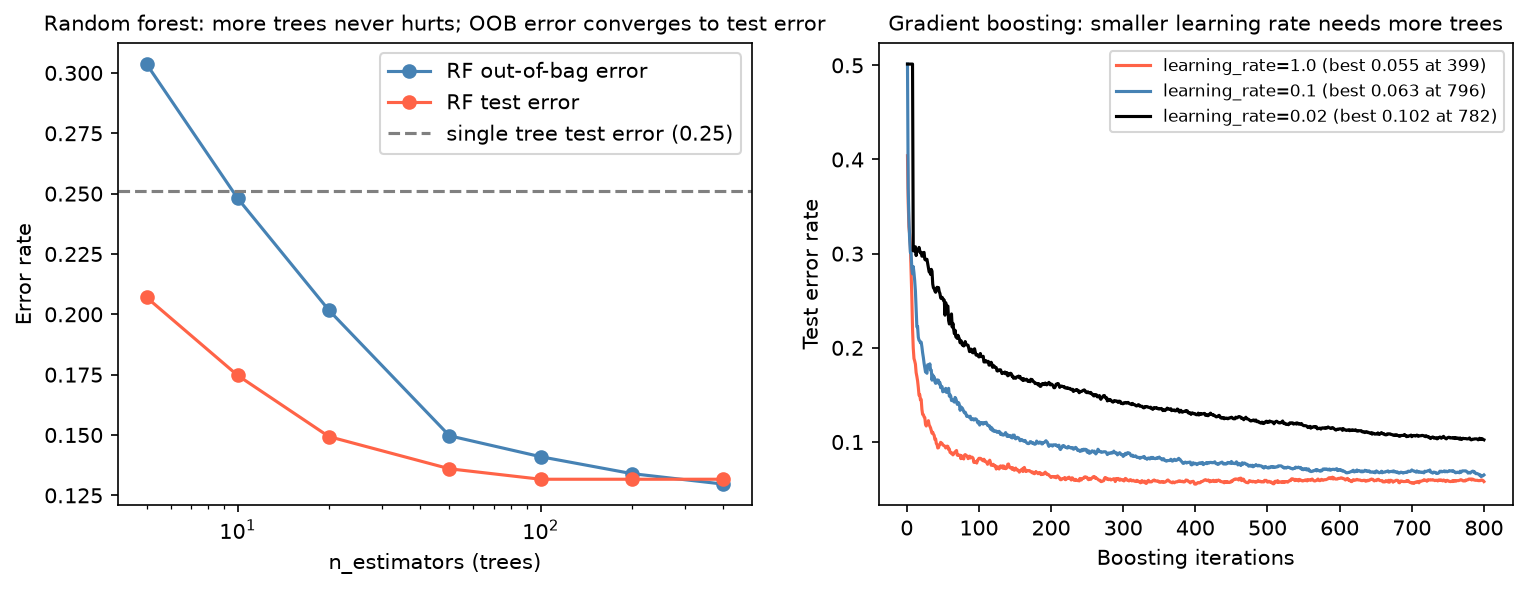
左圖:樹的數量增加,測試誤差單調下降後持平;增加樹只是讓平均更穩定,不增加模型對單一訓練點的記憶。真正控制過擬合的是每棵樹的複雜度(min_samples_leaf、max_features)。OOB 誤差在樹少時偏高(每筆只被少數樹評估),約 100 棵以上才和測試誤差一致。
特性
| 優點 | 缺點 |
|---|---|
| 預設值就很好用,對超參數不敏感 | 模型大、預測比線性模型慢 |
| 不需縮放;能處理 NaN(sklearn ≥ 1.4) | 訓練 accuracy 常接近 1,不能用訓練分數判斷過擬合 |
| 自動捕捉非線性與交互作用 | 無法外推到訓練範圍之外 |
| 內建 OOB 評估 | 機率常被拉向中間,需要時檢查 校準 |
| 可平行 | feature_importances_(MDI)有偏誤 → 用 permutation importance,見 可解釋性 |
變體
ExtraTreesClassifier(Extremely Randomized Trees)連切點也隨機選,更快、變異更低;乳癌資料上 CV AUC 0.991,略高於隨機森林 0.986。
生資常用:表現量 / 甲基化資料的分類、變異致病性預測的特徵模型、微生物組成預測。p ≫ n 時仍需注意 高維小樣本 的驗證設計。