外觀
Machine Learning › 非監督式學習 › 降維 › UMAP
UMAP (Uniform Manifold Approximation and Projection)
和 t-SNE 一樣是非線性嵌入、主要用於視覺化,但通常更快、可以 transform 新資料,也可以嵌入超過 2 維。它是單細胞 RNA-seq 分析(Scanpy、Seurat)的預設視覺化。
| 原理 | 說明 |
|---|---|
| 建鄰居圖 | 每個點連到 n_neighbors 個最近鄰,形成帶權重的圖 |
| 低維最佳化 | 在 2D 找一個圖結構盡量相似的佈局(cross-entropy) |
| 結果 | 保留局部鄰居;群之間的相對位置有時比 t-SNE 稍有意義,但仍不能當成距離解讀 |
參數
| 參數 | 小 | 大 |
|---|---|---|
n_neighbors(預設 15) | 強調局部細節,群被切碎 | 強調較大範圍的結構 |
min_dist(預設 0.1) | 點擠成很緊密的團 | 點較分散、看得到群內結構 |
metric | "euclidean"(預設)、"cosine"、"correlation" 等 | — |
用法
python
# pip install umap-learn(套件名 umap-learn,import umap)
import umap
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

X_scaled = StandardScaler().fit_transform(X)
X_pca = PCA(n_components=30).fit_transform(X_scaled)       # 高維資料先 PCA

reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, n_components=2, random_state=0)
emb = reducer.fit_transform(X_pca)
emb_new = reducer.transform(X_new_pca)                     # 新資料可投影(t-SNE 不行)
設
random_state時 UMAP 會停用平行化以確保可重現,速度變慢;大資料探索時可以不設。
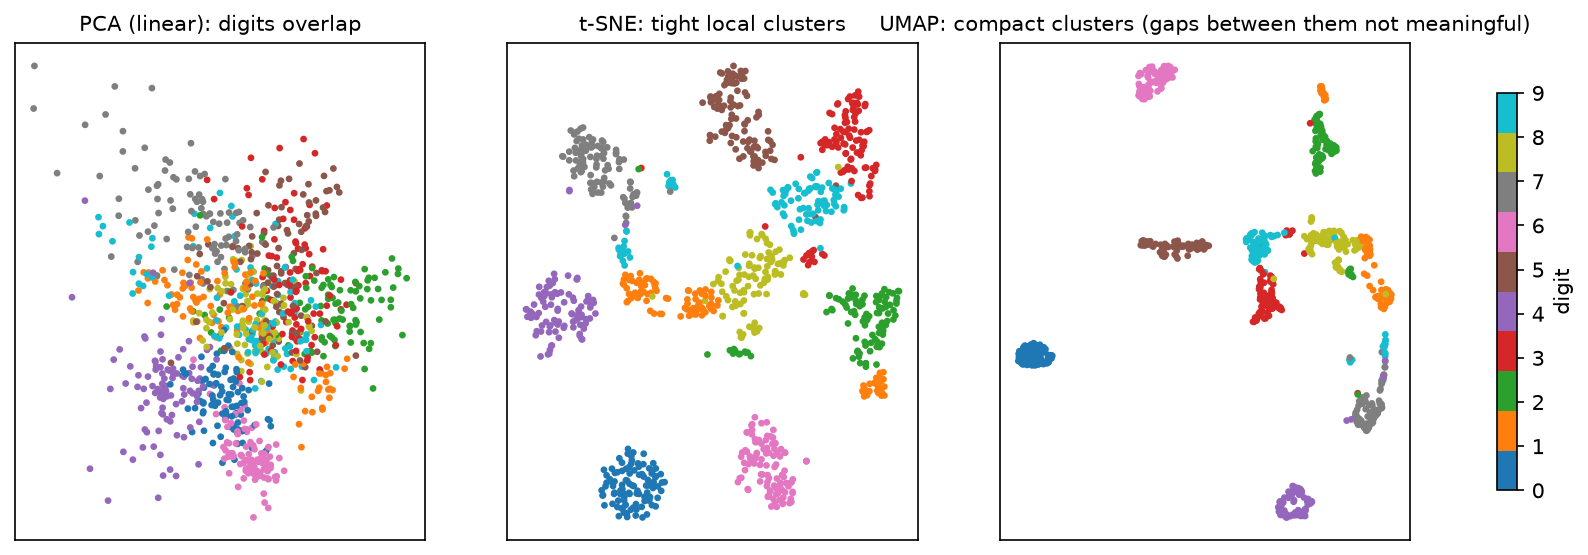
digits 資料(1,000 張 8×8 手寫數字):PCA 是線性投影,各數字大幅重疊;t-SNE 與 UMAP 都把多數數字分成清楚的群,UMAP 的群更緊密。兩者的群間空白與群大小都不代表真實的距離或變異。
t-SNE vs UMAP
| t-SNE | UMAP | |
|---|---|---|
| 速度 | 較慢 | 較快,可處理百萬點 |
| 新資料 | 不能 transform | 可以 |
| 嵌入維度 | 通常 2–3 | 任意(可作為下游分群的輸入) |
| 主要參數 | perplexity | n_neighbors、min_dist |
| 解讀限制 | 群大小、群間距離不可信 | 同樣不可信(只是程度略好) |
生資使用提醒
| 提醒 | 說明 |
|---|---|
| 先 PCA 再 UMAP | 標準流程:正規化 → 高變異基因 → PCA(30–50 PC)→ KNN 圖 → UMAP / Leiden |
| 分群要在 PCA / KNN 圖上做,不要在 UMAP 座標上做 | UMAP 的 2D 座標扭曲了距離 |
| 圖上「分開」的群不一定是不同細胞類型 | 可能是批次、細胞週期、品質;用標記基因與 QC 指標上色驗證 |
| 參數改變會改變圖的外觀 | 結論不要依賴單一張圖;報告時寫出參數 |
| 不要從 UMAP 圖推論連續性或軌跡 | 軌跡分析需要專門方法(pseudotime),見 軌跡分析 |