外觀
Statistics › 多變量分析 › 分群
分群 (Clustering)
非監督式 (unsupervised):不使用標籤,從資料本身找出自然群組。沒有標準答案,結果好不好要結合數學指標與領域知識判斷。這篇是統計觀點的概觀:怎麼選群數、怎麼描述與驗證群;各演算法的原理、參數與程式碼見 ML:分群。
方法概觀
| 方法 | 群的定義 | 適合 | ML 筆記 |
|---|---|---|---|
| K-Means | 離中心最近 | 緊密、球狀、大小相近的群;大資料 | K-Means |
| 階層式 | 依連結方法逐步合併,得樹狀圖 | 未知 k、想看巢狀結構(基因 / 樣本熱圖) | 階層式 |
| DBSCAN / HDBSCAN | 稀疏區隔開的高密度區 | 非球狀、有雜訊 / 離群 | DBSCAN |
| GMM | 多個常態分配的混合 | 橢圓群、需要軟分配機率 | 高斯混合模型 |
| Leiden / Louvain | kNN 圖上的社群 | 單細胞 RNA-seq 標準 | 網路分析 |
距離型方法對量尺很敏感,分群前一定要標準化(或先 PCA)。基因表現 heatmap 的樹狀圖常用 1 − Pearson 相關作為距離 + average linkage,看的是「表現型態相似」而非絕對量相近。
選擇群數 k
| 訊號 | 建議 |
|---|---|
| 手肘在 k = 3 且輪廓係數在 k = 3 最高 | 強烈支持 k = 3 |
| 手肘不明顯,輪廓係數在 k = 2 最高 | 傾向較簡單的 k |
| 兩條曲線都單調下降 | 資料可能沒有明顯群結構 |
| 兩者不一致 | 都檢查,用領域知識判斷 |
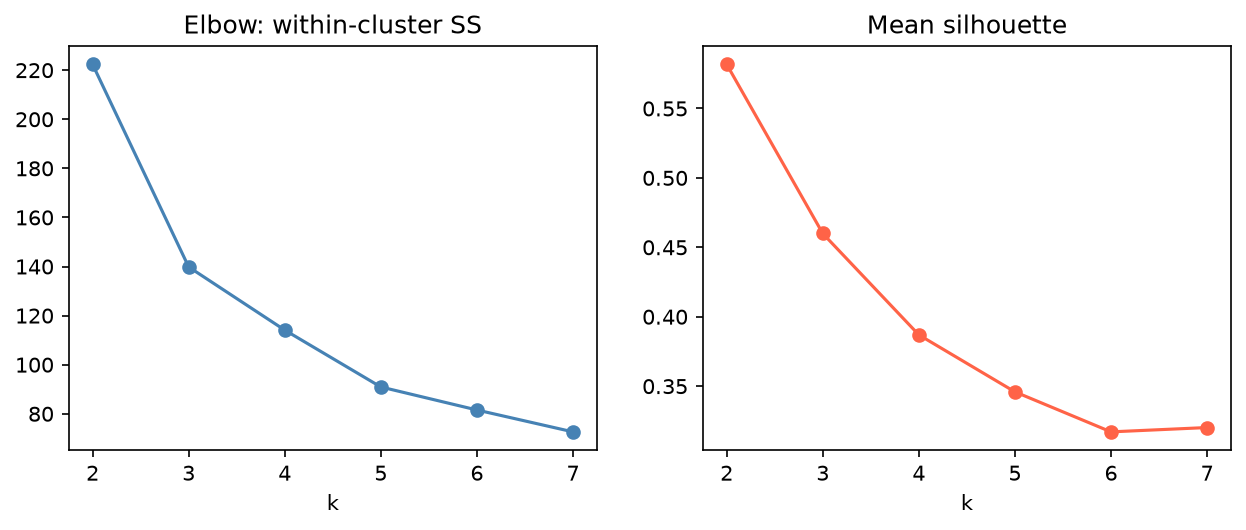
iris 是「兩者不一致」的例子:手肘不明顯,輪廓係數在 k = 2 最高(setosa vs 另外兩種),但真實有 3 個物種。versicolor 與 virginica 在量測空間中重疊,統計指標無法替你決定 k。
評估指標
| 指標 | 需要真實標籤? | 意義 |
|---|---|---|
| 輪廓係數 (silhouette)、Davies-Bouldin | 否 | 群內緊密、群間分離的程度 |
| Inertia (WCSS) | 否 | 群內平方和,k 越大越小(用於手肘法) |
| ARI (adjusted Rand index) | 是 | 與已知分類的一致性(≈ 0 隨機、1 完全一致) |
完整指標表與 sklearn 函式見 ML:評估分群。
描述各群 (Cluster Profiling)
找出群只完成一半,還要描述每群的特徵,把「Cluster 2」變成「花瓣長的大花」或「高表現免疫基因的 T 細胞」。
python
df = iris.data.assign(cluster=labels)                        # labels:任一分群方法的結果
profile = df.groupby("cluster").mean()                       # 偏態變數用 median
sns.heatmap((profile - profile.mean()) / profile.std(), annot=True, cmap="RdBu_r", center=0)
單細胞資料中,這一步就是找各群的 marker genes(常用 Wilcoxon rank-sum)。
分群是假設,不是結論
分群演算法一定會分出群,即使資料沒有真正的群結構。驗證方式:
| 檢查 | 做法 |
|---|---|
| 穩定性 | Bootstrap / 子抽樣後重新分群,看群是否一致(consensus clustering) |
| 前處理敏感度 | 換標準化方式、特徵子集、PCA 成分數,結果是否改變 |
| 領域可解釋性 | 各群在領域語言中是否有意義 |
| 外部驗證 | 在獨立資料上是否重現 |
用分群結果再去檢定「群間差異」是循環論證 (double dipping):群本來就是依差異分出來的,p 值必然很小。